Non addestrare quello che sai già scrivere: il Weight-Space Programming
TL;DR
- Nel Weight-Space Programming (WSP) un modello linguistico legge e scrive direttamente i pesi di una rete neurale a partire da una specifica in linguaggio naturale. Sulla rete finale nessun ottimizzatore fa un solo passo.
- I primi esperimenti, pubblicati a inizio novembre 2026 da quattro ricercatori del MIT CSAIL, hanno numeri notevoli: una rete scritta da zero fa 517,4 punti a Breakout contro i 25,3 di una policy PPO addestrata per 500 milioni di step; una policy bloccata torna a funzionare cambiando il 3,5% dei pesi; un piccolo LLM sale dal 7,9% al 48,1% su MATH-500 dopo una modifica allo 0,016% dei parametri, fatta senza fine-tuning.
- La mia tesi: il training resta indispensabile per ciò che non sappiamo descrivere, mentre ciò che sappiamo descrivere si può programmare direttamente nei pesi.
- Ci scommetterei su edge e IoT, controllori e logiche di stato, verifica di regole su dati strutturati e manutenzione mirata di modelli già in produzione.
Assunti
- "Senza training" si riferisce alla rete prodotta. Il modello che scrive i pesi (negli esperimenti del MIT, GPT-6 Astra) è stato addestrato su scala enorme: la capacità passa da un modello generale a un artefatto piccolo e specifico.
- Serve una funzione descrivibile. Regole, vincoli, soglie, algoritmi noti. Per visione, parlato e segnali rumorosi senza un modello formale, il gradiente resta lo strumento giusto.
- Le evidenze sono giovani. Un blog post di ricercatori del MIT CSAIL, un report indipendente e un preprint, tutti del 2 e 3 novembre 2026 e nessuno ancora sottoposto a peer review. Casi selezionati, già discussi e criticati.
- Un circuito scritto si ispeziona più facilmente, ma va testato come qualunque altro software.
Obiettivo
Mostrare con formule e circuiti perché l'approccio è credibile e dove porta vantaggi concreti: meno training, reti piccole fin dal progetto, inferenza locale, correzioni mirate. In fondo c'è un protocollo per verificarlo sul proprio caso, utile anche per mettere alla prova le mie conclusioni.
Dal Software 2.0 al compilatore che ragiona
Nel 2017 Andrej Karpathy chiamò Software 2.0 l'idea di smettere di scrivere codice e lasciare al gradiente il compito di scrivere i pesi. Da allora la ricetta è questa:
Un dataset , una funzione di perdita e milioni di piccoli passi in discesa. Il WSP sostituisce tutto questo con una funzione più difficile da implementare e molto più semplice da leggere:
dove è la specifica in linguaggio naturale, l'architettura della rete e il modello autore, che ragiona su cosa deve calcolare ogni pezzo della rete. Il gradiente della rete finale, , non viene mai calcolato.
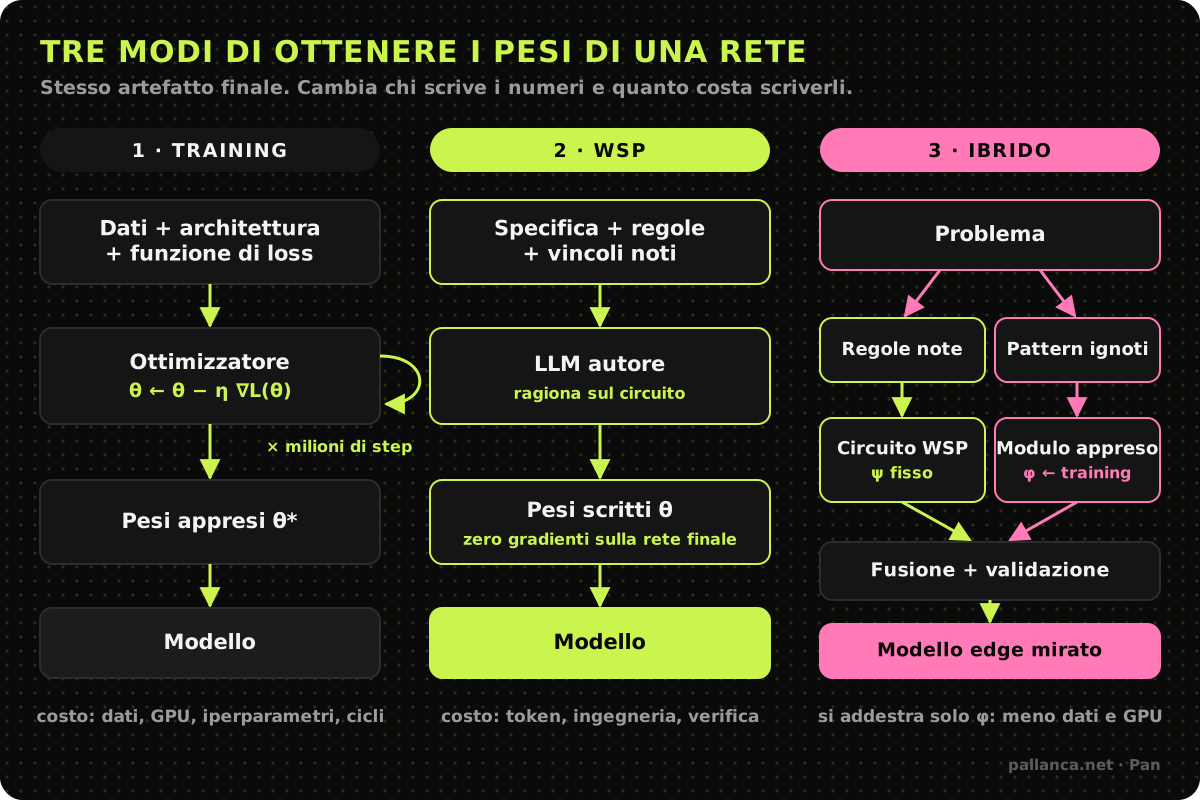
Tre strade per ottenere gli stessi pesi. Tocca un diagramma per aprirlo a piena risoluzione.
Il gradiente resta utilissimo. Per anni, però, lo abbiamo usato anche per insegnare alle reti cose che sapevamo già scrivere: soglie, conteggi, instradamenti, regole. Un po' come pagare un tutor perché insegni le tabelline a una calcolatrice.
Si può davvero scrivere una rete a mano?
Sì, e per i problemi piccoli bastano carta e penna. Prendiamo la parità, un problema che le reti addestrate col gradiente imparano notoriamente male: dati 10 bit, l'uscita vale 1 se il numero di uni è dispari e 0 se è pari. Ecco una rete ReLU con un solo livello nascosto e i pesi scelti a mano:
Ogni unità è una rampa che parte quando il conteggio supera . Con pesi d'uscita alternati le rampe si sommano in un'onda triangolare che vale 0 sugli interi pari e 1 su quelli dispari: per si ottiene .
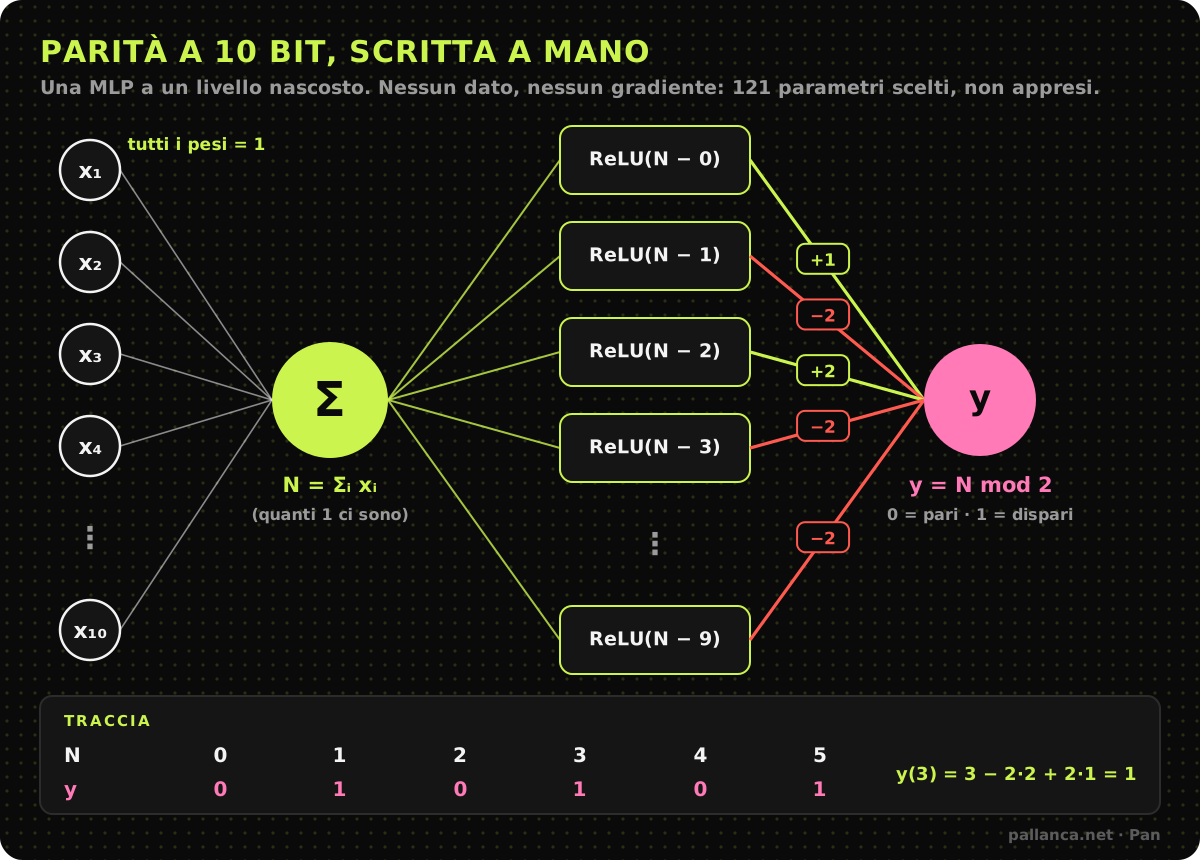
Nel diagramma la somma è disegnata come un nodo per chiarezza: nella rete ogni unità nascosta riceve direttamente i 10 ingressi, con peso 1 e bias .
L'ho verificata su tutti i 1.024 input possibili, senza errori. Ha 121 parametri (100 pesi d'ingresso, 10 bias, 10 pesi d'uscita e un bias finale), di cui 119 diversi da zero, e zero secondi di training. È un esempio didattico costruito da me e non tratto dai paper, ma segue lo stesso tipo di ragionamento che un LLM applica quando programma una rete.
Chandan Singh ha chiesto a un agente di fare la stessa cosa su un transformer. La sua soluzione per la parità fino a 10 bit ha più parametri della mia, 174, ma solo 35 diversi da zero contro i miei 119. Il risparmio viene dall'attenzione: con query e key nulle, la softmax assegna lo stesso peso a tutte le posizioni,
e con posizioni e un peso di value pari a 11 la media torna a essere il conteggio . A quel punto una MLP con nove ReLU calcola . Nello stesso report c'è un trucco che trovo ancora più elegante. Impostando le key al logaritmo del valore posizionale delle cifre,
i pesi d'attenzione diventano proporzionali a 100, 10 e 1, e una sola testa calcola, a meno di una costante, . Nei test di Singh tutti e dieci i compiti algoritmici, dall'addizione all'ordinamento al massimo comun divisore, hanno raggiunto il 100% su 200 esempi entro tre tentativi.
Chi segue l'interpretabilità meccanicistica riconosce il vocabolario: il circuito QK sceglie dove guardare, il circuito OV cosa spostare, le MLP fanno da tabelle di lookup. Nel 2023 Tracr compilava programmi RASP in pesi di transformer con un compilatore scritto apposta. Qui il compilatore è l'LLM.
Breakout: 517 punti senza aver mai giocato una partita
Il risultato più citato viene dal blog post di Takehi, Teoh, Zhang e Khattab. Al modello autore, GPT-6 Astra, danno le regole e il codice sorgente di tre giochi MinAtar e una rete 600 → 32 → 32 → 6 con attivazioni tanh e tutti i pesi a zero. Non ha dati, loss, strumenti né partite di prova: risponde scrivendo i pesi come testo, in un solo messaggio.
| Gioco | PPO, 100M step | PPO, 500M step | WSP, una risposta |
|---|---|---|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
La rete che scrive ha la forma standard di una policy:
La differenza sta nel significato assegnato ai pesi. Per Breakout il modello programma il primo livello in modo che codifichi dove atterrerà la pallina, e il secondo in modo che porti la racchetta in quel punto. È la strategia che conosce chiunque ci abbia giocato dieci minuti, guardare dove scende la pallina e mettersi sotto, tradotta in tre matrici.
Con una regola così netta, la rete scritta batte anche mezzo miliardo di step di reinforcement learning. Su Seaquest e Asterix, dove la strategia buona è meno ovvia, PPO a 500 milioni di step resta davanti, mentre la rete scritta supera comunque PPO a 100 milioni in tutti e tre i giochi. La lettura che ne ricavo è che il vantaggio è massimo dove la regola si lascia scrivere facilmente.
Chirurgia, non trapianto
Per chi ha modelli in produzione conta soprattutto la capacità di correggerli, e il lavoro del MIT ne mostra due esempi.
Nel primo, una policy che deve portare un'auto oltre una rampa si è incastrata in un minimo locale: punta dritto, resta bloccata e in 256 episodi non riesce mai. Il modello autore riceve i pesi, una descrizione della scena e la registrazione di un episodio fallito, capisce che all'auto serve fare retromarcia per prendere la rincorsa e aggiunge un piccolo percorso che legge posizione e velocità e si disattiva dopo il salto. Cambia il 3,5% dei pesi in un solo tentativo, senza strumenti, e l'auto riesce in 1.024 episodi su 1.024.
Il secondo riguarda un LLM vero, Qwen3.5-0.8B, che la sua stessa model card segnala come soggetto a loop di ragionamento. Qui il modello autore lavora con un kernel Python e può eseguire fino a 50 passaggi di prova sul modello, sempre senza gradienti né training. Trova una singola direzione nello spazio delle attivazioni, scritta dalle MLP dei livelli 15 e 19, e la sottrae da 64 colonne della matrice di uscita di ciascuno dei due livelli:
| Qwen | MATH-500 | GSM8K | IFEval | Troncate* |
|---|---|---|---|---|
| Base | 7,9% | 13,8% | 21,0% | 93,0% |
| Dopo l'edit | 48,1% | 67,1% | 62,3% | 33,1% |
* Quota di risposte su MATH-500 che arrivano al limite di 32.768 token.
Gli autori chiariscono da soli la portata del risultato: l'edit elimina i loop, un ostacolo che impediva al modello di usare capacità che aveva già. Su Gemma 3 270M, che va in loop di rado, nessun intervento ha spostato MATH-500 di più di circa un punto. Per la manutenzione questo basta e avanza, perché molti difetti dei modelli in produzione sono proprio comportamenti sbagliati e localizzati, che oggi si correggono con un fine-tuning completo e il rischio di peggiorare qualcos'altro.
Un terzo segnale arriva da un preprint del 3 novembre. Reti piccole, tra 433 e 4.801 parametri, addestrate a verificare quattro regole su richieste di pianificazione radioterapica, sono state sabotate di proposito attraverso i dati di training. Senza strumenti né esecuzione di codice, il modello ha individuato la regola compromessa in 16 reti su 18 e le ha riparate cambiando una mediana di 3 parametri, con verifica su circa 420.000 richieste. Anche il fine-tuning le ha riparate tutte, cambiando però quasi ogni parametro. Gli autori precisano che oggi il WSP trova e ripara questi difetti senza poter certificare che una rete sia corretta, e lo studio non dice nulla sull'idoneità clinica. Resta un indizio concreto di una manutenzione dei modelli più vicina al debugging del software.
I conti che mi fanno essere ottimista
Il vantaggio economico emerge con l'ammortamento. Una funzione eseguita volte costa
Se la rete WSP costa meno da eseguire, cioè , conviene rispetto a un modello addestrato quando
Quando anche la costruzione costa meno, perché non servono dataset etichettati, GPU e cicli di iperparametri, il numeratore è negativo e la rete scritta conviene dalla prima inferenza. Quando costa di più, conviene comunque oltre . Un sensore che decide mille volte al giorno, installato su diecimila dispositivi, accumula dieci milioni di inferenze in una giornata.
Ci sono due condizioni tecniche. Modificare pochi pesi lascia invariata la dimensione del modello: Qwen dopo l'edit pesa esattamente come prima. Memoria ed energia si risparmiano quando la rete è progettata piccola, attorno al circuito minimo necessario, come il transformer di parità da 174 parametri. E la sparsità fa risparmiare solo se il runtime e l'hardware la sfruttano.
Lo schema in cui vedo il valore maggiore è ibrido, e separa quello che sappiamo da quello che dobbiamo imparare:
I pesi sono programmati (compensazioni fisiche, soglie, policy di decisione) e restano congelati; i pesi sono addestrati, per la variabilità che nessuno sa descrivere a priori. Se i blocchi programmati sono differenziabili il gradiente li attraversa senza modificarli, altrimenti si addestra su una loss propria, a monte della policy.
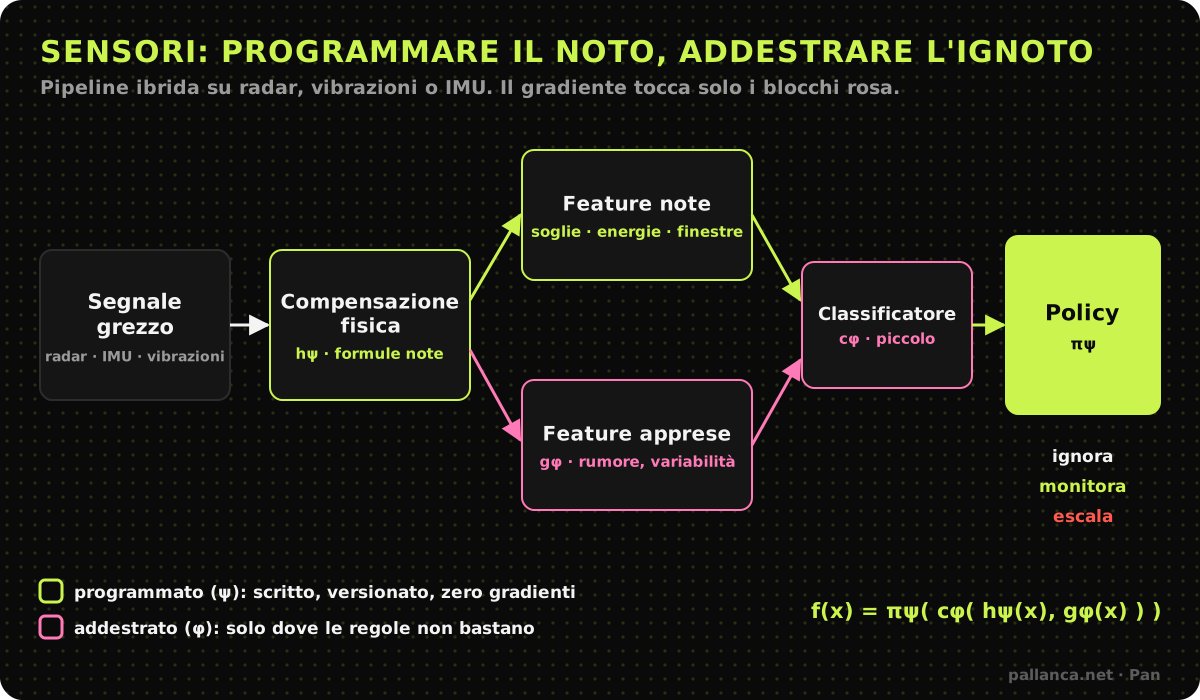
Il gradiente aggiorna solo i blocchi rosa (); quelli verdi () sono scritti, versionati e congelati.
Il modulo appreso, che non deve più imparare la fisica già nota, tende a essere più piccolo e a chiedere meno dati. Diminuiscono però solo i dati per imparare il comportamento: quelli per verificarlo servono come prima, duecento o mille casi reali su cui misurare precision, recall e calibrazione.
Dove ci scommetterei, e come verificarlo
Sui controllori e le logiche di stato, dove le regole esistono già e vanno solo tradotte. Sulla verifica di regole e di compliance su feature strutturate. Sull'instradamento e la pre-elaborazione di segnali su dispositivi edge, dove ogni milliwatt conta e il cloud è lontano. Sulla manutenzione di modelli esistenti, dove oggi si rifà un fine-tuning per correggere un singolo comportamento. Cambierebbe anche il ruolo dei foundation model, usati come progettisti di funzioni piccole, verificate e locali invece che chiamati a ogni inferenza. Per la privacy è un buon affare: quello che gira sul dispositivo resta sul dispositivo.
Il proof of concept che farei confronta quattro soluzioni sulla stessa funzione, con gli stessi input:
| Braccio | Soluzione | A cosa serve |
|---|---|---|
| A | Codice deterministico ottimizzato | Capire se serve davvero una rete |
| B | Piccolo modello addestrato | La baseline ML classica |
| C | Rete WSP, zero training | Isolare il vantaggio del paradigma |
| D | Ibrido WSP + modulo addestrato | Trovare il compromesso migliore |
Il braccio A va fatto per primo: se un if ben scritto risolve il problema, la rete neurale aggiunge solo complessità. Il criterio di successo è raggiungere la qualità richiesta dal compito con un vantaggio misurabile su almeno una dimensione rilevante, come latenza al p95, memoria di picco, joule per inferenza, costo di costruzione o tempo per correggere un difetto. Battere B in accuracy, da solo, dice poco.
Le critiche, e perché resto ottimista
Le critiche migliori sono arrivate il giorno dopo. Matthew Honnibal osserva che il post del MIT mette insieme tecniche molto diverse: alcuni esperimenti leggono i pesi grezzi senza strumenti, quello su Qwen usa Python e passaggi di prova, e presentarli insieme fa sembrare la capacità più uniforme di quanto sia. Sean Goedecke sostiene che un buon ricercatore umano avrebbe potuto fare le stesse cose, e che il modo migliore di aggiornare i pesi resta il training.
Sul primo punto Honnibal ha ragione, ed è il motivo per cui qui ho tenuto separati i casi e le condizioni di ciascuno. Del secondo argomento condivido metà. Un ricercatore esperto può fare a mano un'analisi come quella su Qwen, ma ci mette giorni, mentre un modello la fa in un pomeriggio, a costo marginale, e la può ripetere su mille reti. Quanto al training, resta la scelta migliore per ciò che va scoperto dai dati; per ciò che è già noto, la scrittura diretta sta mostrando reti più piccole, più rapide da ottenere e più leggibili.
Il passo successivo sono i confronti puliti del protocollo qui sopra, a partire dal braccio A. Se sul vostro caso la rete scritta batte sia il codice deterministico sia il modello addestrato su latenza o energia, a parità di qualità, avete un motivo concreto per adottarla. Io mi aspetto di vederlo succedere prima di tutto sui dispositivi edge, dove ogni milliwatt risparmiato si moltiplica per migliaia di esemplari.
Fonti
- R. Takehi, J. Teoh, A. Zhang, O. Khattab (MIT CSAIL), Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights, 2 novembre 2026.
- C. Singh, Weight-Space Programming from scratch on simple tasks, 2 novembre 2026.
- H. Nusrat, O. Nusrat, Weight-space programming for auditing clinical decision networks, preprint arXiv, 3 novembre 2026.
- M. Honnibal, The 'Astra can read and write weights to improve Qwen' post is misleading, 3 novembre 2026.
- S. Goedecke, LLMs are not superhuman at reading and writing neural network weights, 3 novembre 2026.
- D. Lindner et al., Tracr: Compiled Transformers as a Laboratory for Interpretability, 2023.